IA em call center
IA na ligação: o que já funciona hoje e o que ainda é promessa
· atualizado em 27 de setembro de 2026 · 11 min de leitura
“Tem IA” virou frase que significa cinco coisas em cinco estágios diferentes. Transcrever uma ligação é problema resolvido, com ressalvas conhecidas. Deixar um robô negociar um acordo é outra categoria, e essa ainda quebra. Este texto separa os pedaços e diz, de cada um, onde o erro cai.
A cadeia tem quatro elos, e o primeiro contamina os outros três
Toda IA de ligação faz o mesmo caminho: áudio → texto → interpretação → ação. A ação é o que você compra — o campo gravado na tabulação, a nota de qualidade, a decisão de dar desconto. Ninguém compra transcrição por transcrição.
E o erro do primeiro elo não fica no primeiro elo: o que a transcrição perde, a interpretação não recupera. A saída também não vem com cara de erro — vem escrita, formatada e em tom de certeza. A pergunta que separa demonstração de produção: quando esse elo erra, quem percebe?
E “IA na ligação” não é um produto só. Posto numa régua, cada pedaço está numa idade diferente:
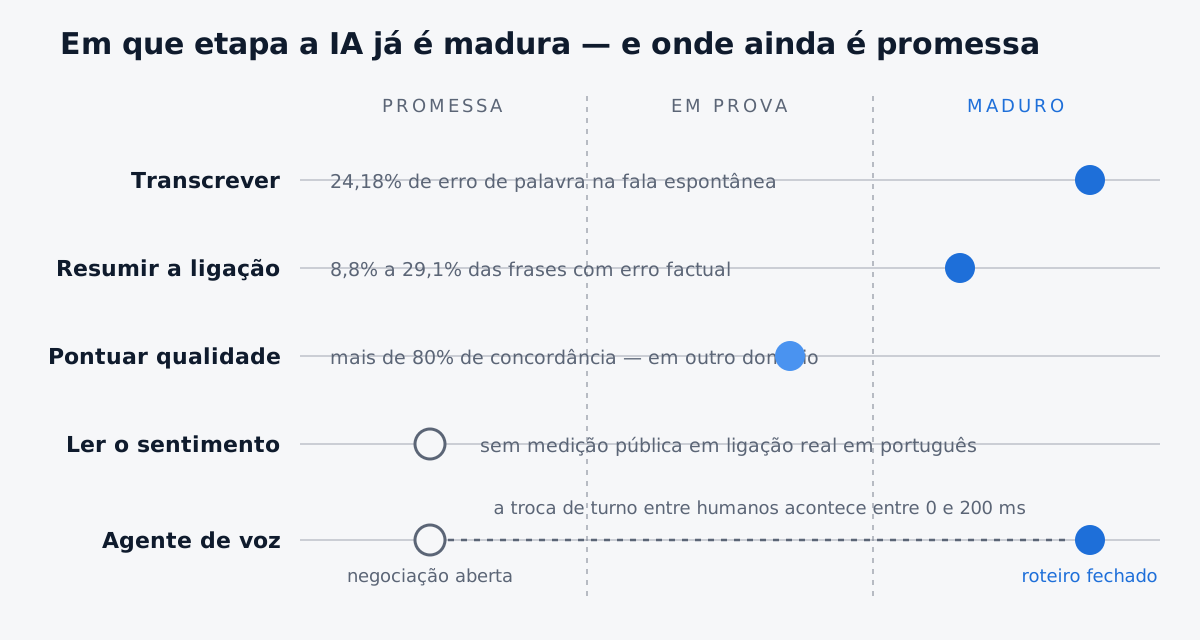
A única faixa com dois pontos é a que mais aparece em proposta comercial: “agente de voz” nomeia ao mesmo tempo o que já funciona e o que ainda não — e é o contrato que diz qual dos dois você comprou.
Transcrição: madura, e o telefone é o pior caso dela
Comece pelo fato físico. A telefonia clássica trabalha com áudio amostrado a 8 kHz e faixa de voz de cerca de 300 Hz a 3.400 Hz — a banda estreita das recomendações da ITU-T. O que se perde no topo é onde as consoantes se distinguem umas das outras. Some fala espontânea, duas pessoas falando junto, ruído de sala e celular em movimento: ligação de cobrança é o pior caso da transcrição, não o caso médio.
Um par de números mostra o tamanho do efeito. O corpus CORAA ASR, com 290 horas de português brasileiro validado manualmente, serviu para ajustar um modelo wav2vec 2.0 XLSR-53: deu 24,18% de taxa de erro de palavra no teste do próprio CORAA (fala espontânea) contra 20,08% no Common Voice (fala preparada), segundo o artigo em Language Resources and Evaluation. São números de 2022 e de um modelo só; os de hoje vão melhor. O que o par mostra continua valendo: o mesmo modelo erra mais na fala espontânea — e sua operação só tem fala espontânea.
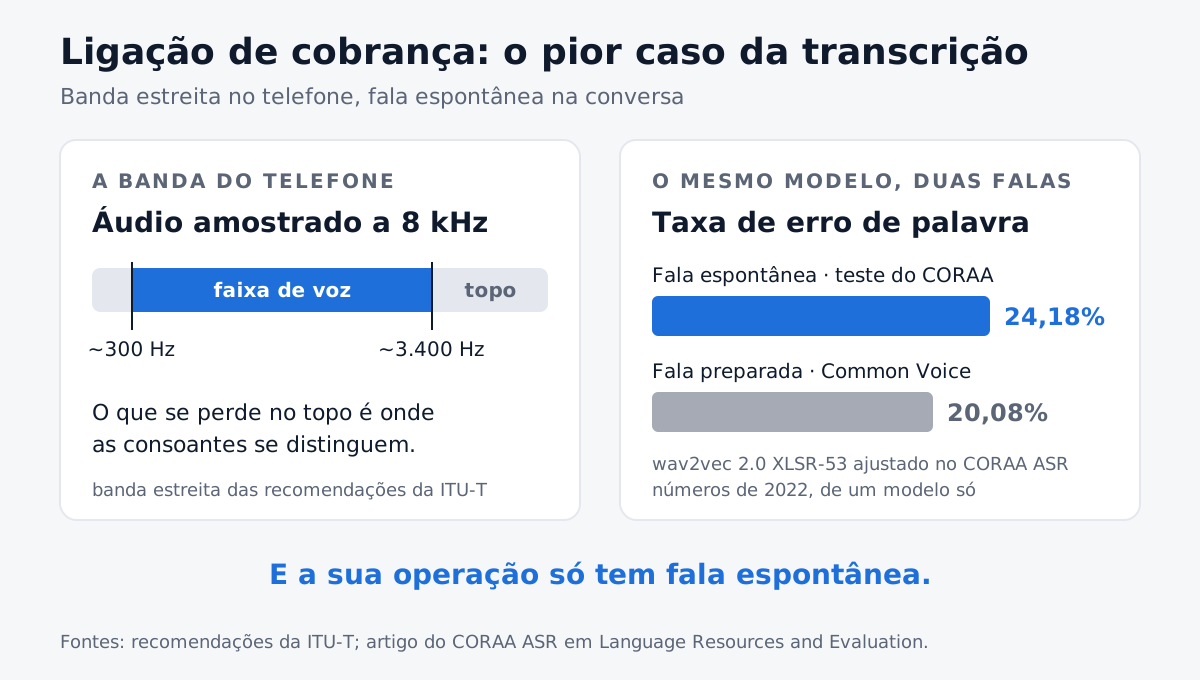
O telefone corta o topo da voz e a cobrança só tem fala espontânea: os dois lados do pior caso — com a ressalva de que os números são de 2022 e de um modelo só.
O risco maior não é o erro de palavra: é a alucinação. No estudo Careless Whisper, apresentado na conferência FAccT em 2024, os autores encontraram cerca de 1% de transcrições com frases inteiras que não existiam em forma alguma no áudio, e 38% dessas alucinações traziam dano explícito — violência, associações falsas, autoridade inventada. O trabalho associa parte das invenções a trechos longos sem voz.
Erro de palavra você lê e percebe; alucinação sai fluente e com a pontuação certa. E a operação é cheia de áudio sem voz: música de espera, tom de URA, caixa postal que ninguém desligou. Detectar voz antes de transcrever, e não mandar ao modelo o que não é voz, é prevenção barata. Confundir máquina com gente no começo da chamada já tem post só sobre isso.
Resumo e tabulação: o ganho é o pós-atendimento, o risco é o campo
É o item da lista com o ganho mais fácil de medir. O mecanismo é direto: depois de desligar, o operador passa um tempo digitando o que aconteceu, com o cliente fora da linha. O resumo automático ataca esse pedaço — e quantos segundos devolve é medida sua, não promessa de fornecedor.
Um atendimento de cobrança simulado, da primeira fala à tabulação:
O risco está em deixar o texto virar o dado. O benchmark TofuEval, de 2024, anotou frase a frase a consistência factual de resumos de diálogo feitos por modelos de tamanhos diferentes: a taxa de frases com erro factual foi de 8,8% a 29,1% conforme o modelo, num mesmo conjunto. E piorou quando o pedido era resumir tópico pouco presente na conversa — aí o modelo preenche com conhecimento próprio. Em cobrança: peça “resuma a promessa de pagamento” numa ligação sem promessa e você recebe uma promessa.
Daí a regra que se sustenta em produção: texto livre pode ser gerado; campo estruturado tirado da conversa é sugestão, nunca dado. Valor, data, parcelas e código de tabulação que a IA sugere se conferem contra o sistema que calculou a negociação, e quem grava é o operador. O resumo entra como sugestão e o operador confirma num clique — a confirmação é o controle, e fica registrada com nome e hora.
O risco está em deixar o texto virar o dado. Valor, data, parcelas e código de tabulação que a IA sugere se conferem contra o sistema que calculou a negociação, e quem grava é o operador.
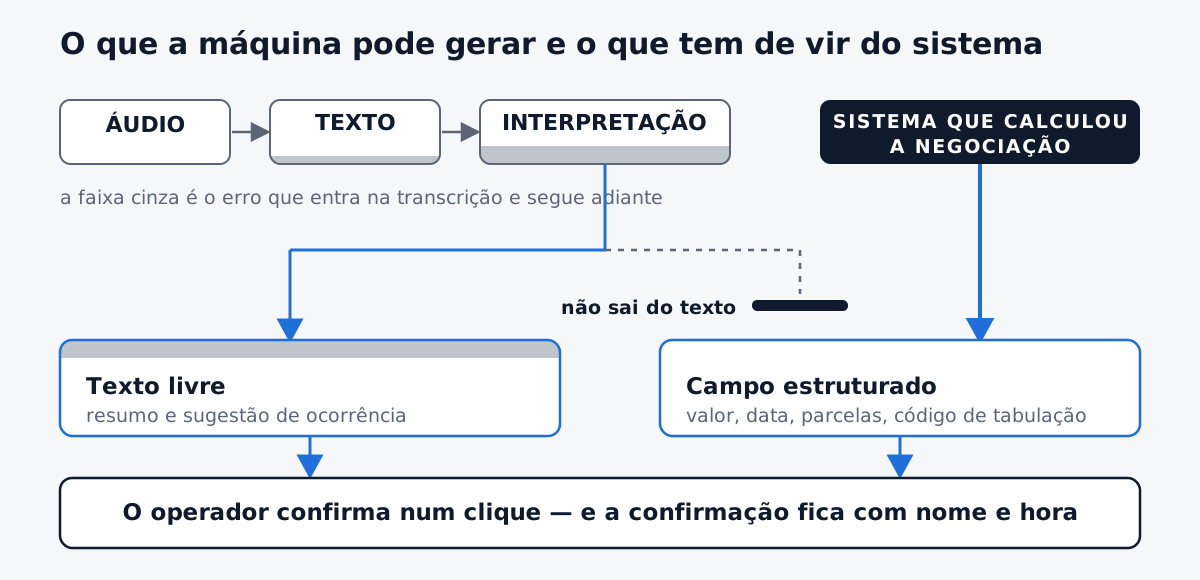
Repare que só o ramo de texto carrega a faixa cinza adiante: o campo estruturado não herda o erro da transcrição porque nunca passou por ela.
Onde ligação e cadastro moram muda essa conta, e isso é assunto de outro post.
Avaliação de qualidade: o que mudou foi a amostra, não o juiz
A monitoria tradicional ouve uma amostra de cada operador — quantas ligações por período, cada operação define a sua. Com transcrição automática dá para pontuar todas. Esse ganho é real: é cobertura.
O que não mudou foi o julgamento. Quando o juiz é um modelo de linguagem, dois fatos convivem. Em Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena (NeurIPS, 2023), juízes fortes alcançaram mais de 80% de concordância com a preferência humana — o mesmo patamar da concordância entre humanos; o mesmo trabalho documentou vieses de posição, de verbosidade e de auto-preferência. E o TofuEval achou que, como avaliadores binários de factualidade, os modelos perdem para métricas especializadas. Nenhum desses testes foi feito em ligação de cobrança em português.
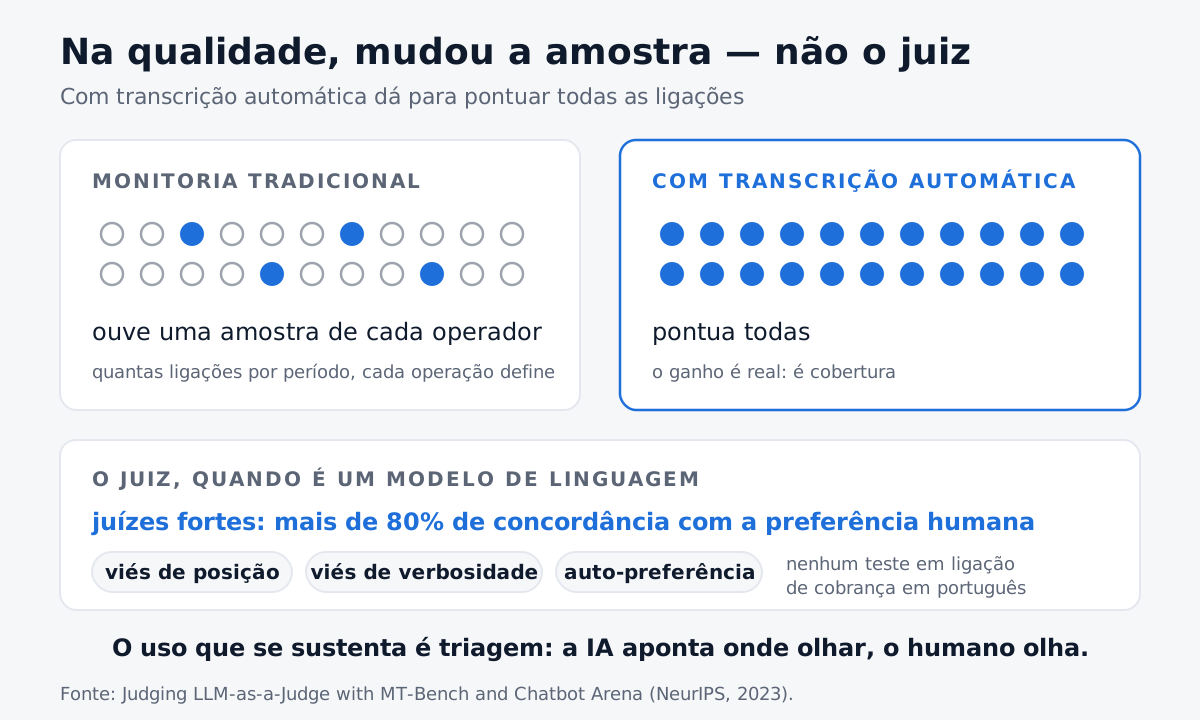
O ganho é cobertura; o julgamento não mudou — e os testes de juiz automático citados aqui são de outro domínio.
O uso que se sustenta é triagem: a IA aponta onde olhar, o humano olha. Nota que vira consequência — bônus, plano de melhoria, desligamento — é outra história. Vale um detalhe do texto vigente: o art. 20 da LGPD (Lei nº 13.709/2018) dá ao titular o direito de pedir revisão de decisão tomada unicamente com base em tratamento automatizado, mas o trecho que exigia revisão por pessoa natural foi suprimido pela MP nº 869/2018, convertida na Lei nº 13.853/2019, com o veto mantido pelo Congresso. A lei, como está, não garante que quem revisa seja gente. Confira a redação vigente na fonte oficial: isto não é orientação jurídica. E a boa prática independe da lei — nota que muda a vida de alguém precisa de um humano que assine e de contestação que fique gravada.
Análise de sentimento: o elo mais fraco da lista
É o recurso mais vendido e o menos sustentado. A revisão sistemática de reconhecimento de emoção na fala publicada na JMIR Mental Health em 2025 aponta o problema de base: boa parte dos conjuntos de treino usa emoção atuada ou semiatuada, que difere da espontânea, com viés e generalização entre culturas e faixas etárias em aberto. E modelos fundacionais de fala são otimizados para conteúdo fonético, tendendo a abstrair a pista paralinguística — justamente a que o sentimento precisa.
Não localizei medição pública de acerto de sentimento em ligação real de cobrança em português. Sem isso, “sentimento negativo” é pista para um humano ouvir, não indicador de operador.
Pelo mesmo áudio rende mais o evento objetivo: sobreposição de fala, silêncio longo, aumento de volume, pedido de supervisor, palavra de risco dita pelo devedor — “advogado”, “Procon”, “processo”. Detecta-se sem inferir estado de espírito, e sobrevive a auditoria porque a gravação prova.
Agente de voz: roteiro fechado funciona, negociação aberta ainda não
Funciona hoje, com resultado verificável: lembrete de vencimento, confirmação de recebimento, segunda via, agendamento de retorno, triagem e transbordo para humano. São diálogos curtos, de erro visível e barato.
Negociação aberta é outra categoria, por três motivos.
Ritmo. No estudo de Stivers e colegas publicado na PNAS em 2009, medindo conversa em dez línguas, o pico das trocas de turno acontece entre 0 e 200 ms. É a régua com que se julga se do outro lado tem gente — e quem deve não procura motivo para ficar na linha.
Assimetria do erro. Resumo errado custa retrabalho. Valor errado dito ao telefone vira acordo indevido e reclamação — foi gravado e o cliente ouviu.
Lastro jurídico. Cobrança não é pergunta e resposta. O que o agente diz é proposta com valor, prazo e consequência, e vincula o credor: quem fala precisa estar preso às condições que o sistema aprovou, e a frase dita fica gravada do lado de lá também.
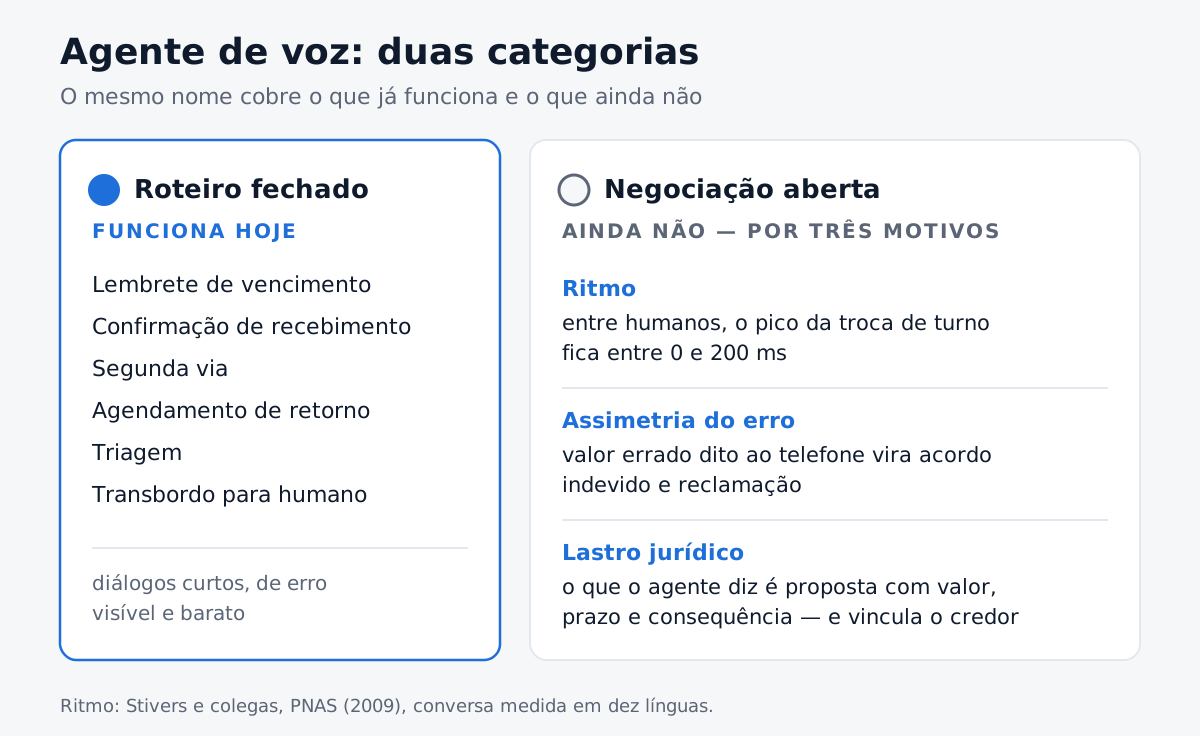
À esquerda, diálogos curtos em que o erro aparece e custa pouco; à direita, frase dita que vira proposta e fica gravada do lado de lá.
Sobre regra: existe norma federal de SAC — o Decreto nº 11.034/2022 — que prevê atendimento humano disponível ao consumidor nos serviços regulados pelo Poder Executivo federal. Ela trata do SAC, não da cobrança ativa, que segue outras regras: Anatel e 0303 estão em outro post. E o PL 2338/2023, marco legal de IA, tramitava no Congresso e, até esta publicação, não havia virado lei. Confirme o texto vigente e o estágio de cada uma na fonte oficial; isto não é orientação jurídica.
Duas previsões da mesma casa, em sentidos opostos
Em março de 2025 a Gartner divulgou que, até 2029, a IA agêntica resolveria sozinha 80% das questões comuns de atendimento. Em janeiro de 2026, que até 2030 o custo por resolução com IA generativa superaria o de um agente humano offshore. São previsões, não medições, e não se contradizem: automatizar volume e economizar dinheiro são coisas separadas. Quem compra IA pelo discurso de corte de pessoal compra a primeira e paga a segunda.
Cinco perguntas antes de assinar
- Rode a transcrição em 20 ligações minhas, do meu tronco, e me mostre o texto cru — sem revisão e sem áudio de demonstração.
- Em que porcentagem das chamadas o operador corrigiu o campo sugerido? Quem não tem esse log não tem como melhorar o modelo.
- O valor do acordo nasce no texto gerado ou no sistema que fez o cálculo?
- O que o sistema faz com 20 segundos de música de espera?
- A nota de qualidade é contestável, e a contestação fica registrada com nome de quem revisou?
Do que este texto mostrou, o que se sustenta em produção:
- Detecte voz antes de transcrever. Música de espera, tom de URA e caixa postal que ninguém desligou não vão para o modelo.
- Trate campo tirado da conversa como sugestão. Valor, data, parcelas e código de tabulação se conferem contra o sistema que calculou a negociação, e quem grava é o operador.
- Use a nota automática como triagem. A IA aponta onde olhar; nota que muda a vida de alguém precisa de um humano que assine e de contestação que fique gravada.
- Prefira o evento objetivo ao sentimento. Sobreposição de fala, silêncio longo, aumento de volume, pedido de supervisor, palavra de risco — a gravação prova.
- Separe roteiro fechado de negociação aberta. Lembrete, segunda via, agendamento e transbordo funcionam hoje; negociação aberta, ainda não.
Escolher fornecedor tem post próprio, e os números da discagem moram em outro lugar.
O que não deu para confirmar
Não achei medição pública e independente de taxa de erro de transcrição em ligação real de cobrança em português, em banda estreita: existe benchmark de corpus e existe fornecedor medindo a si mesmo — e nós também não publicamos a nossa. Quando houver, sai o método junto com o número; número sem método é propaganda. Não achei estudo comparando nota automática com nota de monitor humano em operação brasileira — os benchmarks de juiz automático citados aqui são de outro domínio. Não achei segundos economizados por chamada com resumo automático fora de material comercial. Não confirmei exigência legal brasileira, em vigor, de avisar o consumidor de que ele fala com uma máquina em cobrança. E a latência de agente de voz publicada hoje é quase toda de quem vende agente de voz.
Perguntas frequentes
A IA transcreve bem uma ligação telefônica?
Transcrição é madura, mas o telefone é o pior caso dela: a telefonia clássica trabalha com áudio amostrado a 8 kHz e faixa de voz de cerca de 300 Hz a 3.400 Hz, e ligação de cobrança é fala espontânea. No corpus CORAA, um modelo wav2vec 2.0 ajustado deu 24,18% de taxa de erro de palavra na fala espontânea, contra 20,08% na fala preparada do Common Voice — números de 2022 e de um modelo só; os de hoje vão melhor, mas o mesmo modelo erra mais na fala espontânea. Não achei medição pública e independente de taxa de erro de transcrição em ligação real de cobrança em português, em banda estreita.
O que é alucinação na transcrição de áudio?
É a frase inteira que aparece no texto e não existe no áudio. No estudo Careless Whisper, apresentado na FAccT em 2024, cerca de 1% das transcrições tinha frases assim, e 38% dessas alucinações traziam dano explícito. O trabalho associa parte das invenções a trechos longos sem voz — por isso detectar voz antes de transcrever é prevenção barata.
A IA pode preencher a tabulação da ligação sozinha?
Texto livre pode ser gerado; campo estruturado tirado da conversa é sugestão, nunca dado. Valor, data, parcelas e código de tabulação que a IA sugere se conferem contra o sistema que calculou a negociação, e quem grava é o operador. No benchmark TofuEval, de 2024, a taxa de frases com erro factual em resumos de diálogo foi de 8,8% a 29,1%, conforme o modelo.
Dá para usar IA para avaliar a qualidade de todas as ligações?
Com transcrição automática dá para pontuar todas, e esse ganho é real: é cobertura. O que não mudou foi o julgamento: no trabalho Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena (NeurIPS, 2023), juízes fortes passaram de 80% de concordância com a preferência humana, e o mesmo trabalho documentou vieses de posição, de verbosidade e de auto-preferência. Nenhum desses testes foi feito em ligação de cobrança em português, e o uso que se sustenta é triagem: a IA aponta onde olhar, o humano olha.
Análise de sentimento em call center é confiável?
É o elo mais fraco da lista. Segundo a revisão sistemática de reconhecimento de emoção na fala publicada na JMIR Mental Health em 2025, boa parte dos conjuntos de treino usa emoção atuada ou semiatuada, que difere da espontânea. Não localizei medição pública de acerto de sentimento em ligação real de cobrança em português; sem isso, “sentimento negativo” é pista para um humano ouvir, não indicador de operador.
Um agente de voz com IA consegue negociar dívida?
Roteiro fechado funciona hoje: lembrete de vencimento, confirmação de recebimento, segunda via, agendamento de retorno, triagem e transbordo para humano. Negociação aberta ainda não: é outra categoria, por três motivos — ritmo, assimetria do erro e lastro jurídico. O que o agente diz é proposta com valor, prazo e consequência, e vincula o credor.